Een datagedreven parfum-vergelijker die geuren matcht op geurprofiel
Vooraf was er wel ruwe geurdata, maar die was volledig Engelstalig, deels uit scrapes (met licentierisico) en met de geurnoten enkel als vrije tekst. Commerce-data zoals prijzen, shops, volumes en EAN ontbrak volledig en moest uit affiliate-feeds komen. De architectuur moest bovendien twee valkuilen vermijden: trage postmeta bij duizenden offers die per feed-run updaten, en crawl-bloat door duizenden waardeloze SEO-pagina's. De kernuitdaging: rommelige multi-bron geurdata combineren met live prijsfeeds tot één snel, SEO-veilig en Nederlandstalig platform.
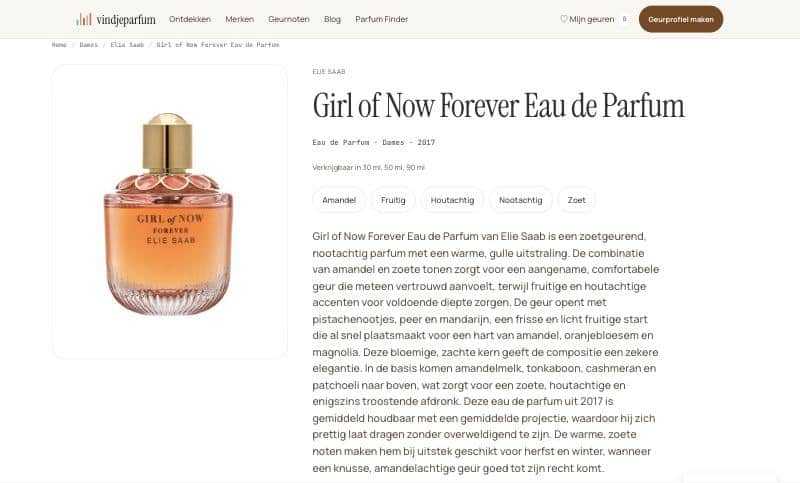
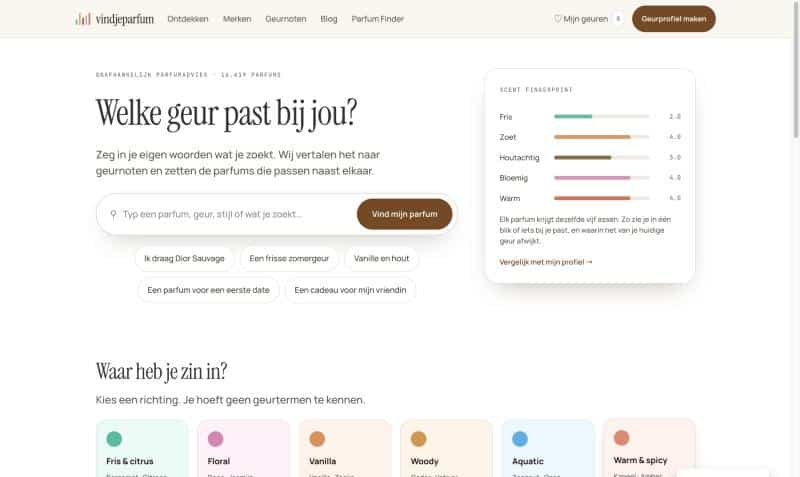
Eén centrale custom plugin ("Vindjeparfum Core", 75+ modulaire PHP-componenten) met een bewuste tweelagenarchitectuur: native Divi 5 voor presentatie en SEO, en een eigen applicatielaag met 13 custom databasetabellen voor de high-write data (varianten, offers, prijsgeschiedenis, feature-vectoren, aanbevelingen). Daarbovenop een data-afgeleide fingerprint en recommendation-engine, geautomatiseerde affiliate-feed-import met normalisatie en matching, AI-gegenereerde Nederlandse beschrijvingen (lost taal én licentie op), programmatische SEO/GEO-pagina's, affiliate-redirect, prijsalerts en geautomatiseerde socialevideo-publicatie.
Een live, grotendeels zelfonderhoudend platform waar eenzelfde parfum over meerdere shops vergeleken wordt, met een geurzoeker die op profiel aanbeveelt en een programmatische SEO/GEO-structuur (schema.org, llms.txt, IndexNow) die de catalogus citeerbaar maakt voor zoekmachines én AI-assistenten. De data groeit automatisch mee met nachtelijke feed-syncs en AI-contentgeneratie.
Aanpak in fasen
We kozen bewust voor een hybride model: WordPress-CPT's en taxonomieën voor de SEO- en redactiewereld, en custom MySQL-tabellen voor de high-write offer-wereld. Zo werken Yoast, Divi en de REST API vanzelf mee, terwijl de engine losgekoppeld en schaalbaar blijft. Dit werd eerst als voorstel ter goedkeuring uitgeschreven vóór de volledige ontwikkeling.
We analyseerden de beschikbare brondatasets en kozen de meest gestructureerde als ruggengraat. De 5-dimensionale fingerprint wordt afgeleid uit de circa 84 schone accords in plaats van uit circa 1.671 rommelige losse noten, wat een stabielere geurvector oplevert. De losse noten blijven voor de notenpiramide (met een EN naar NL-vertaaltabel), en de Nederlandse beschrijvingen worden met AI gegenereerd om taal- en licentieproblemen in één keer op te lossen.
We bouwden feed-adapters voor meerdere affiliate-netwerken (Awin, Daisycon, Bol.com, CJ), met generieke import, normalisatie en dedup naar varianten en offers, dagelijkse sync-crons, matching van feed-producten op de parfum-entiteit en een voorberekende recommendation-tabel.
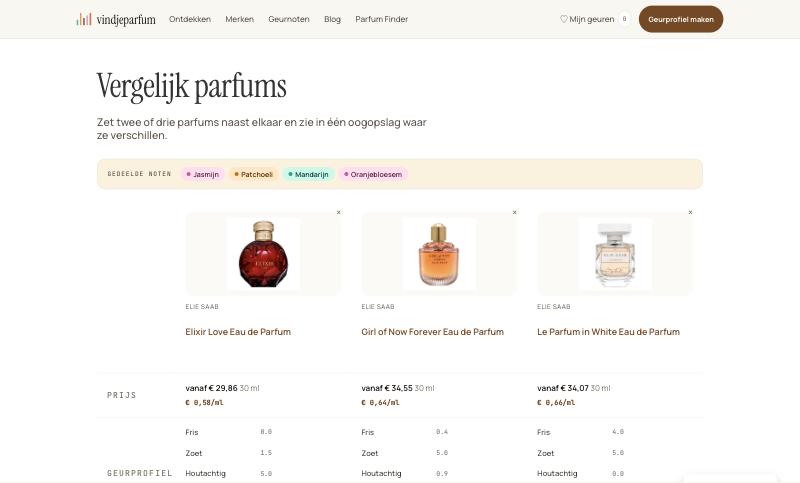
Programmatische landingspagina's (merk, geurnoot, accord, seizoen), "ruikt zoals", "X vs Y" en "beste ..."-pagina's, structured data en een llms.txt-laag voor GEO, plus een geautomatiseerde pijplijn die socialevideo's rendert en publiceert naar YouTube, TikTok, Instagram en Facebook.
“Het platform draait vlot en grotendeels op automatische piloot. Telkens we iets willen aanpassen of bijbouwen, is de opvolging snel en vakkundig, en de afterservice is echt uitstekend.”
Gebruikte technologie
Eigenschappen
In beeld